

在机器学习(ML)中,通常会向计算机展示大量数据,让它们检测某些模式并学习变量之间的关系。因此,在训练 ML 模型时,必须收集大量数据。
数据是 ML 的核心,因此高质量的数据集对于建立准确的 ML 模型至关重要。在本文中,您将了解如何为您的 ML 项目收集数据。
数据源概述
因为没有数据就不可能完成 ML 流程,所以收集数据通常是 ML 项目生命周期的第一步。以下是一些可以收集所需数据的来源。
预建数据集
在某些情况下,必要的数据可能是现成的。您可以在Kaggle 等网站、国际货币基金组织(IMF)或世界银行等国际机构或提供即用数据集的公司找到大量数据集。
Kaggle:热门选择
Kaggle 是一个广受欢迎的 ML 数据源。它拥有成千上万的公共数据集,其中大部分是 CSV 格式,在 ML 中广泛使用。下载数据集非常容易,但要注意的是,有些数据集的大小可能高达数十 GB。
注册免费账户并登录后,您可以导航到数据集中心,在那里您可以选择多种类型的数据集。例如,您可以下载 NFL Big Data Bowl 2025 数据集,该数据集也是您可以参加的一项活跃竞赛。选择好数据集后,进入其页面,参加比赛,点击 “下载全部“按钮,然后下载一个 ZIP 文件:

ZIP 文件包含 CSV 文件,其中包含在 NFL 大数据杯 2025 数据集上训练 ML 项目所需的所有数据。
Kaggle 提供了大量数据集,其中大部分用于教育目的。
以业务为重点的数据集
如果您正在寻找适合业务需求的数据集,可以考虑探索商业数据集市场。您可以从亚马逊、沃尔玛、X (Twitter)、LinkedIn 和 Instagram 等一些最受欢迎的网站上找到数百个预建数据集。
这些数据集的优势之一是它们已经为 ML 项目格式化。数据的准确性和质量通常都有保证,而来自 Kaggle 等开放平台的数据集则未必如此。如果您需要电子商务网站、房地产或社交媒体网站的数据,这些市场提供了一个很好的起点。
例如,您可以利用预构建的 Twitter 数据集来获取有关 X 帖子或个人资料的各种数据点。您可以利用这些数据进行情感分析、监控品牌声誉或定位有影响力的人。
数据采集应用程序接口
另一种收集数据的方法是通过 API,许多组织都提供这种 API。一些著名的例子包括 YouTube API、Google API 和 Reddit API。例如,YouTube API 可以方便地访问有关视频、频道和播放列表的各种数据点(如标题、描述、观看次数、点赞、评论和上传日期)。您还可以使用 API 创建播放列表、向其中添加视频、编辑设置等。YouTube API 是免费的,但每天有 10,000 个配额。
根据组织的不同,API 可以是免费的,也可以是付费的。无论如何,当您需要数据时,最好先查看是否可以通过 API 获取,然后再从其他来源获取数据。
自定义数据的网络抓取
到目前为止,我们一直专注于使用预建数据集或 API 来获取数据。然而,在许多情况下,您需要的特定数据可能无法随时获取。您必须依靠网络搜索来收集数据。
无论信息的结构如何,Web scraping 都能让你直接从网页中提取数据。本文稍后将向你展示具体的操作方法。
网络抓取的注意事项
在开始扫描数据之前,您需要注意一些事项:
- 考虑您需要什么样的数据。这在很大程度上取决于您的 ML 项目的性质以及您想要实现的目标。您可以选择使用结构化数据(表格中的数据)或非结构化数据(如文本、图像、音频或视频)。
- 考虑你需要的数据量。更多的数据通常会带来更准确的结果,但也更难收集。
- 决定数据来源。如果要从网上搜刮数据,请决定使用哪个网站。
此外,说到网络搜刮,重要的是要始终牢记所搜刮网站的条款和条件。你应该始终遵守网站关于数据搜刮的规定。几乎所有网站都有一个robots.txt文件,它告诉网络搜刮者哪些网页可以搜刮,哪些网页禁止搜刮。该文件通常可以通过在网站的根域中添加/robots.txt找到。例如,您可以在https://www.amazon.com/robots.txt 找到亚马逊的robots.txt文件。
网络抓取工具
最后,您必须决定使用哪些工具进行网络搜索。这主要取决于任务的复杂程度。
对于小型刮擦任务,Beautiful Soup 等 Python 库通常就能胜任。但是,对于复杂的任务,您可能需要更高级的工具。一种选择是使用受管理的 网络搜刮 API,它具有高度可扩展性,符合各种数据保护法律(如《通用数据保护条例》(GDPR)和《加利福尼亚消费者隐私法案》(CCPA)),无需高级编码技能即可轻松使用,并且能够处理反搜刮机制。
如何收集用于 ML 的数据
在介绍了潜在的数据源之后,让我们来看看刮擦网站以收集用于多重L 的数据所需的步骤。
先决条件
在本示例中,你将从Quotes to Scrape网站上抓取报价,该网站专门用于网络抓取示例。本示例使用 Python,因此如果你想继续学习,请确保安装了 Python。
设置虚拟环境
首先,建立一个虚拟环境。这并不是强制性的,但通常是一种好的做法。
在 Windows 中,你可以在命令提示符中输入python -m venv quotes 来创建一个新的虚拟环境。然后,你可以使用quotes\Scripts\activate 命令激活它。如果创建成功,你将在命令提示符中看到新虚拟环境的名称quotes:
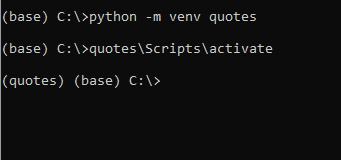
如果要在其他操作系统中激活虚拟环境,可以参考“Python 虚拟环境入门 “中的说明:A Primer “中的说明。
进入新的虚拟环境后,您需要安装所需的库。在这里,你将使用 Requests 向目标网站发送 HTTP 请求,使用 Beautiful Soup 解析 HTML 并提取我们需要的数据,使用pandas清理和处理数据。所有这些都可以用pip install requests beautifulsoup4 pandas 安装。
安装所需库函数后,打开 Jupyter Notebook、Google Colab 或新建一个名为scrape.py 的文件。然后,使用以下命令导入依赖库:
from bs4 import BeautifulSoup
import requests
import pandas as pd
从网上收集数据
既然场景已经设置好了,那么就可以进行实际的搜索了。您要搜索的网页是 http://quotes.toscrape.com/page/11/:
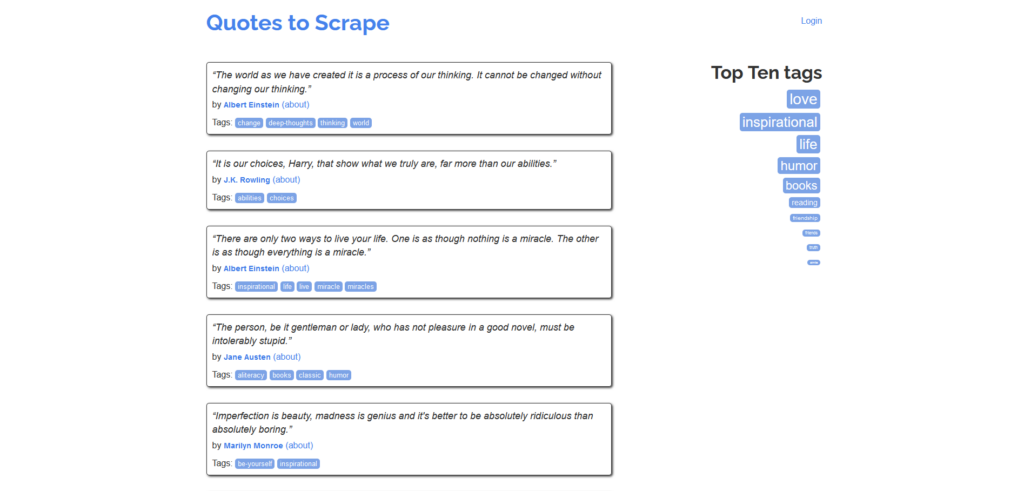
使用请求功能,您需要向所需网页发送 HTTP 请求并接收响应。然后,您就可以使用 Beautiful Soup 来解析接收到的 HTML 文件,方便日后从中提取数据。为此,请在您的环境中运行这段代码:
url = "https://quotes.toscrape.com/"
response = requests.get(url)
soup = BeautifulSoup(response.text, 'html.parser')
解析 HTML 文件后,需要分析 HTML 的结构。由此,您可以看到每个项目的可用数据点,如引文、作者和标记。第一条引文的 HTML 结构如下:

其他报价也采用了相同的结构。
所有项目都在一个 <div>元素中,该元素的类名为quote。因此,您可以用下面一行代码抓取所有引号:
quotes = soup.find_all("div", class_="quote")
现在,您需要循环浏览所有引语,抓取它们的文本、作者和第一个标签(为简化示例,只抓取第一个标签),并将所有这些内容存储在单独的列表中。您可以通过以下代码片段完成所有这些操作:
#creating empty lists to store the scraped data
texts = []
authors = []
tags = []
#loop through the quotes, extract the data, and store in a list
for quote in quotes:
    texts.append(quote.find("span", class_="text").text)
    authors.append(quote.find("small", class_="author").text)
    tags.append(quote.find("a", class_="tag").text)
如果在脚本中编写代码,可以使用终端或命令提示符导航到脚本所在的文件夹,然后运行python scrape.py。如果使用的是 Jupyter Notebook,则只需运行所有单元格即可(如果尚未运行)。
至此,你已经有了针对不同数据点的独立 Python 列表。稍后,您将学习如何从这些列表中获取信息、清理信息并存储信息。
处理动态内容和分页
虽然你迄今为止所做的一切都很适合教育目的,但当你要抓取一个真实的网站时,你可能会面临一些障碍。你可能会遇到的一个常见问题是动态内容。动态内容通常由 JavaScript 支持,指的是当你浏览网页时会自动更改的网页内容。虽然这对用户很有用,但却会给网络刮擦程序带来问题。
动态内容的问题在于,请求只能获取服务器返回的静态 HTML,但无法获取 JavaScript 呈现的动态内容,这意味着在抓取动态内容时,必须使用 Selenium 等其他工具。从本质上讲,Selenium 可以让你控制网络浏览器。
首先打开一个新文件,如scrape_amazon.py或一个新的 Jupyter Notebook。继续安装和导入 Selenium。如果你使用的是 Jupyter Notebook,可以用以下代码执行安装和导入:
!pip install selenium
!pip install webdriver-manager
from selenium import webdriver
from selenium.webdriver.support.ui import WebDriverWait
如果创建了scrape_amazon.py文件,则可以在终端或命令提示符下安装这些依赖项。唯一不同的是,你应该去掉行首的!
安装好 Selenium 后,让我们搜索亚马逊的产品评论来测试一下。
首先,您需要确定一款产品,以便搜索其评论。在这里,你将搜索亚马逊电子产品中最畅销的产品,它就是亚马逊 Fire 电视棒。
确定产品后,设置要抓取的 URL(给定产品的评论),使用 Selenium 初始化网络浏览器实例,并导航到所需的网页。最后,检索当前加载页面的 HTML:
url = "https://www.amazon.com/product-reviews/B0CJM1GNFQ"
driver = webdriver.Firefox()
driver.get(url)
html = driver.page_source
然后,利用 Beautiful Soup 解析 HTML 并找到所有评论:
soup = BeautifulSoup(html)
reviews = soup.find_all("div", class_="review")
现在是时候循环浏览所有评论,提取您感兴趣的数据点,并将其存储在 Python 列表中。在本示例中,我们将抓取评论本身、评分、给出评论的产品配置以及评论日期。这可以通过以下代码来完成:
product_reviews = []
ratings = []
configurations = []
review_dates = []
for review in reviews:
    comment = review.find("span", class_="review-text")
    product_reviews.append(comment.text)
    rating = review.find("i")
    ratings.append(rating.text)
    configuration = review.find("a", class_="a-size-mini")
    configurations.append(configuration.text)
    review_date = review.find("span", class_="review-date")
    review_dates.append(review_date.text.split("on ")[1])
您可能已经注意到,亚马逊评论页面每页只显示十条评论。如果产品评论超过十条,您就需要进入后续页面。这意味着您必须设置代码,查看是否有下一页面,如果有,则跟踪下一页面。您可以选择修改代码,在发送另一个请求前等待几秒钟,因为您不想发送请求的速度太快。这可以使用时间模块中的sleep()函数来实现,您必须使用import time 来导入该函数。
您还可以限制要搜索的评论数量,因为热门产品可能有成千上万条评论。请注意,有时亚马逊会要求您登录。如果出现这种情况,您需要创建一个免费的亚马逊账户,登录后重新运行代码。所有这些步骤的最终代码如下所示:
url = "https://www.amazon.com/product-reviews/B0CJM1GNFQ"
product_reviews = []
ratings = []
configurations = []
review_dates = []
while True:
    driver.get(url)
    html = driver.page_source
    soup = BeautifulSoup(html, "html.parser")
    reviews = soup.find_all("div", class_="review")
    for review in reviews:
        comment = review.find("span", class_="review-text")
        product_reviews.append(comment.text)
        rating = review.find("i")
        ratings.append(rating.text)
        configuration = review.find("a", class_="a-size-mini")
        configurations.append(configuration.text)
        review_date = review.find("span", class_="review-date")
        review_dates.append(review_date.text.split("on ")[1])
    try:
        next_page_url = soup.find("li", class_="a-last").find("a")["href"]
    except:
        break
    else:
        url = "https://www.amazon.com" + str(next_page_url)
    if len(product_reviews) > 18:
        break
    time.sleep(10)
如果你一直在scrape_amazon.py文件中编写代码,可以打开终端或命令提示符,导航到脚本所在的文件夹,然后运行python scrape_amazon.py。如果你使用的是 Jupyter Notebook 或 Google Colab,只需运行所有单元格即可。就像在Quotes to Scrape示例中一样,您可以为亚马逊产品的所有方面分别创建 Python 列表。
在下一节中,您将学习如何处理这些 Python 列表中的数据。
清理和准备数据
无论硬件和算法多么先进,如果没有良好的数据,模型的性能都会受到影响。在 ML 领域,最广泛使用的一句话就是 “垃圾进,垃圾出”。这反映了一个事实,即如果使用糟糕的数据作为输入,训练出来的 ML 模型就不会非常有用。这就是为什么清理和准备数据的过程如此重要。
如果你一直在跟进,那么现在数据应该已经提取出来了。我们将使用最流行的 Python 数据分析和处理库 pandas。
首先,您需要创建一个 DataFrame。DataFrame 本质上是一个有行和列的表格,是 pandas 的基本数据结构之一。用以下代码创建一个 DataFrame:
df = pd.DataFrame(list(zip(product_reviews, ratings, configurations, review_dates)), columns=["product_review", "rating", "configuration", "review_dates"])
使用print(df.head(5)) 命令,你可以看到所获取数据集的前五个实例:

pandas 在处理和清理数据方面非常有用。在下面的代码片段中,有一些基本的清理步骤,包括删除空行、删除重复数据和处理缺失值:
#removing empty rows
df.dropna(inplace=True)
#removing duplicates
df.drop_duplicates(inplace=True)
#imputing missing values with the next observation
df.fillna("bfill", inplace=True)
刮擦网站时,您可能会看到数据中存在不同的特殊性。你也应该努力清除这些内容。例如,在亚马逊的评论数据中,你可以看到评论文本包含换行符(newline character),这可能是你进一步分析所不需要的。你还可以看到评分是一个完整的字符串。如果它只是一个整数就更合理了。下面的代码将所有字符替换为空字符串,这样就只保留了评分的数字表示:
df = df.map(lambda x: x.replace('\n', '') if isinstance(x, str) else x)
df = df.rating.str.split(' ').str[0].astype(float).astype(int)
现在,如果运行print(df.head(5)) ,就会得到一个更干净的数据集:

以 CSV 格式存储数据
一般来说,您会希望导出刮擦数据,以便进一步分析。数据可以多种格式导出和存储。最常用的格式之一是 CSV 文件。使用 pandas,将刮擦的数据导出为 CSV 文件非常简单,只需一行代码,如下所示:
df.to_csv("amazon_reviews.csv")
此时,您可以使用简单的命令停用虚拟环境:deactivate。
如果数据量较大,可以考虑使用 BigQuery 或亚马逊简单存储服务(Amazon S3)等基于云的选项。
在进行网络搜刮时,请记住某些网站会限制您的搜刮器可以发送的请求,从而有效地阻止您的 IP 进行搜刮。要想继续搜刮,最好的办法就是利用旋转代理。由于反搜刮机制的普遍存在,代理几乎是任何大规模搜刮的必备条件。
有不同类型的代理,各有利弊。对于网络搜刮来说,旋转代理是理想的选择,因为它们提供了一种无缝的方式,可以避免被发现并保持稳定的访问。
说到代理服务器,选择一家信誉良好、拥有大量轮换代理服务器的代理服务器提供商至关重要。好的代理服务通常能提供数百万个住宅 IP、广泛的地理覆盖、高网络正常运行时间、快速度和高成功率。您可以选择住宅、ISP、数据中心或移动代理。
结论
好的数据集对任何 ML 项目都至关重要。因此,在利用 ML 之前,您必须先对数据集进行初步整理。
在这篇文章中,你了解了数据的不同来源、从网络收集数据的前提条件、如何收集数据、如何清理和准备数据以及如何将数据存储为 CSV 文件。你还了解了代理在网络搜索中的重要性。
如果您决定通过网络搜刮来收集数据,那么使用可靠的代理服务器提供商和托管搜刮服务是非常有益的。这些解决方案具有高质量旋转代理、自动验证码解码、网络搜刮 API 和预建数据集等功能,为简化大规模 ML 数据收集提供了强大的方法。
立即开始访问高质量数据集,让您的 ML 项目更高效、更可扩展。
正在寻找数据提供商?阅读我们的商业数据提供商指南。
常见问题
在机器学习中,计算机通过检测大量数据中的模式和关系来进行学习。高质量的数据集对于建立准确的机器学习模型至关重要,因为训练过程需要大量高质量的数据才能有效。
主要数据源包括:
– 预建数据集:来自 Kaggle、IMF、世界银行等平台或商业市场
– API:由 YouTube、谷歌和 Reddit 等机构提供
– 网页抓取:直接从网页中提取数据,用于定制数据集
Kaggle 是一个流行的数据源,托管着成千上万的公共数据集,大多数都是 CSV 格式。使用方法:
1. 注册免费账户
2.导航至数据集中心
3.选择一个数据集(它们可能有几十GB)
4. 下载包含 CSV 文件的 ZIP 文件
5.提取数据并用于 ML 项目训练
以业务为重点的市场提供来自亚马逊、沃尔玛、Twitter、LinkedIn 和 Instagram 等热门网站的预构建数据集。优势包括:
– 已为 ML 项目格式化
– 准确性和质量有保证
– 针对电子商务、房地产或社交媒体
– 商业应用可靠
应用程序接口(API)提供了从组织获取数据的便捷途径。例如,YouTube API 提供:
– 视频、频道和播放列表数据(标题、描述、查看次数、点赞、评论)
– 创建播放列表和编辑设置的功能
– 免费访问,每天有配额(通常为 10,000 个)。
在以下情况下使用网络搜索:
– 您需要的特定数据无法通过预建数据集或 API 轻松获取
– 您需要其他地方无法提供的自定义数据
– 数据可在网站上公开获取,但无法以数据集的形式提供
– 您需要从多个来源大规模收集数据
重要考虑因素:
– 数据类型:决定结构化(表格)与非结构化(文本、图像、音频、视频)
– 数据量:更多的数据通常会带来更好的结果,但也更难收集
– 数据来源:决定要搜刮哪些网站
– 合规性:始终遵守网站条款和 robots.txt 文件
工具取决于任务的复杂程度:
– 小型任务:Python 库,如 Beautiful Soup
– 复杂任务:处理反抓取机制、提供可扩展性并确保符合 GDPR/CCPA 的托管网络抓取 API
– 高级工具:用于动态内容的 Selenium
对于动态内容:
– 使用 Selenium 控制 Web 浏览器(请求无法获取 JavaScript 渲染的内容)
– 在搜刮之前等待内容加载
– 处理分页以从多个页面收集数据
– 在请求之间实施延迟以避免检测
代理至关重要,因为:
– 网站限制请求,可以阻止您的 IP 进行搜索
– 反搜索机制可以阻止数据收集
– 轮流使用代理提供了无缝的方式来避免检测
– 为大规模搜索保持一致访问
使用 pandas 进行清理:
– 去除空行和重复
– 处理缺失值(估算或去除)
– 去除不需要的字符(如 \n )
– 适当转换数据类型
– 验证数据一致性
– 记住:”垃圾进,垃圾出”。
存储选项包括:
– CSV 文件:最常见的格式,易于使用 pandas 导出
– 云存储:用于大型数据集的 BigQuery 或 Amazon S3
– 数据库:用于结构化关系数据
– 数据湖:用于非结构化或混合数据类型
对于 ML 数据收集,请使用:
– 轮流代理:避免检测和保持访问一致性的理想选择
– 大型 IP 池:数百万个住宅 IP,覆盖范围广泛
– 高网络正常运行时间:可靠的提供商,速度快,成功率高
– 地理覆盖范围:根据需要访问特定地区的数据
Bright Data 是 ML 数据收集的绝佳选择,它提供:
– 拥有数百万住宅 IP 的高质量旋转代理
– 自动验证码解决
– Web scraping API 和预建数据集
– 符合 GDPR 和 CCPA
– 简化的大规模数据收集
– 提供即用型 ML 数据集的数据集市场


Leave a Comment
Required fields are marked *