

Scrapingdog是一款网络搜刮工具,它通过处理反僵尸机制、管理代理和渲染 JavaScript 来简化网站数据收集工作。它面向开发人员和企业,提供了一种经济高效、简单直接的方法来提取结构化数据,而无需手动管理刮擦工具的复杂性。
该产品获得了积极的用户反馈,在 Trustpilot 上获得了 4.8 分(满分 5 分)的高分(基于 570 条评论)。本评论将分析 Scrapingdog 的功能、使用方法、定价和性能,以确定其对不同用户需求的有效性。
概况
Scrapingdog 于 2020 年 4 月由 Manthan Koolwal 和联合创始人 Darshan Khandelwal 创立,公司的愿景非常明确:通过消除管理代理、处理 JavaScript 繁重页面和绕过反僵尸保护等复杂问题,简化网络数据提取。自 2020 年 5 月获得第一个付费客户以来,Scrapingdog 不断改进其 API 驱动的方法,使其成为需要结构化网络数据的开发人员和企业的一个引人注目的解决方案。
与需要大量设置和基础架构管理的传统网络搜刮工具不同,Scrapingdog 提供了一种精简的 API 优先方法。这样,用户就可以提取数据,而不必担心旋转代理、验证码或在动态页面上执行 JavaScript。不过,这种便利也有一定的代价。虽然 Scrapingdog 的 API 非常适合市场调研、价格监控、社交媒体分析和潜在客户生成,但其功能取决于用户的技术熟练程度。它支持针对特定地区收集数据的地理定位,但与一些企业级竞争对手相比,其覆盖范围较为有限。默认情况下,它依赖于数据中心代理,而高级住宅代理需要额外付费–对于僵尸保护更严格的网站来说,这一点值得考虑。
虽然 Scrapingdog 可以绕过基本的验证码,但更高级的机制(如 Google 的 reCAPTCHA v3)可能仍然需要外部解码服务,从而增加了大规模刮擦操作的成本和复杂性。对于大流量用户来说,较低级订阅计划的 API 请求限制也会造成限制,因此大规模数据提取必须进行升级。此外,网站结构经常变化,这意味着虽然 Scrapingdog 提供了坚实的基础,但用户可能仍然需要定期调整其刮擦配置,以保持数据的准确性。
作为一款基于 API 的工具,Scrapingdog 主要是为开发人员设计的,因此非技术用户不太容易使用它,他们可能更喜欢 Octoparse 这样的无代码搜索解决方案。虽然 Scrapingdog 在许多标准使用案例中表现出色,但它可能难以应对部署了指纹识别、高级行为分析和其他尖端反抓取技术的高度保护平台。对于处理此类高安全性网站的用户,可能需要额外的变通方法或替代解决方案。
对于那些正在寻找最佳替代方案的用户,Bright Data 的 Scraper API 为 100 多个网站提供了专门的 Scraper API,是一个全面的刮擦解决方案。对于需要高可靠性和大型代理网络的企业来说,这是一个极佳的选择。
Scrapingdog 提供的产品
扫瞄器应用程序接口
Scrapingdog 提供一套专用的 scraper API,旨在简化跨各种平台的目标数据提取。这些 API 允许用户检索解析 JSON 格式的结构化数据,使开发人员和企业能够无缝集成。从搜索引擎结果、产品列表、财务数据到社交媒体内容,Scrapingdog 的 scraper API 可满足各种用例的需求。

Scrapingdog 的很大一部分搜索功能是专门针对谷歌生态系统的,为谷歌搜索、地图、新闻、趋势、图片、购物和金融等服务提供 API。Google Search Scraper API 尤其适用于竞争分析、研究和搜索工具开发,而 Google Maps API 则有助于提取基于位置的数据,如企业列表和评论。
谷歌新闻(Google News)和谷歌趋势(Google Trends)API 可用于媒体监测和市场趋势分析,而谷歌图片(Google Images)API 则可用于检索图片搜索结果,支持数字营销和内容研究方面的应用。此外,谷歌购物(Google Shopping)和谷歌产品(Google Products)等应用程序接口允许电子商务企业跟踪多个销售商的产品列表和定价数据。
更专业的 Google API,如 Google Jobs、Google Scholar、Google Patents 和 Google Finance,为招聘、学术研究和财务分析等行业提供特定领域的数据提取。
除 Google 生态系统外,Scrapingdog 还为电子商务、社交媒体和在线目录提供专用 API。亚马逊 Scraper API 对于从亚马逊提取产品信息、评论和定价细节至关重要,有助于价格跟踪、竞争对手研究和电子商务分析。社交媒体平台也有很好的覆盖,包括 LinkedIn、Twitter、Instagram 和 YouTube 的 API。
LinkedIn Scraper API 可从公开资料和公司页面中提取数据,是招聘、潜在客户生成和专业网络分析的重要工具。同样,Twitter Scraper API 可帮助收集推文、用户资料和元数据,有助于进行情感分析和社交媒体趋势跟踪。YouTube Scraper API 允许用户检索视频搜索结果、频道信息和视频描述,因此对媒体聚合和数字营销战略非常有用。
对于就业市场和房地产数据,Scrapingdog 提供专门的 API,如 LinkedIn Jobs Scraper、Indeed Scraper API 和 Zillow Scraper API。这些 API 可帮助企业和研究人员以最小的工作量提取职位列表、就业趋势和房地产市场洞察。此外,Yelp Scraper API 使企业能够从评论和评级中收集消费者情感数据,支持市场分析和客户体验监控。
通过提供这些有针对性的 scraper API,Scrapingdog 为多个行业的数据提取需求提供了可靠、可扩展的解决方案。无论企业是需要跟踪市场趋势、分析客户情绪还是收集竞争情报,Scrapingdog 的 API 驱动方法都能确保他们以最低的技术开销获取所需的信息。
截图 API
Scrapingdog 的屏幕截图 API 可用于捕获任何网页的高质量、全页面或特定视口屏幕截图,绕过了手动渲染、无头浏览器和反僵尸措施的复杂性。该解决方案适用于需要可视化网页数据以进行监控、分析或存档的开发人员和企业;API 可无缝集成到各种工作流程中,提供速度、可靠性和易用性。
Screenshot API 的突出特点之一是能够处理 JavaScript 繁重的网站,确保页面在捕获前已完全加载。这对于抓取动态内容(如股票图表、新闻文章、社交媒体资料和交互式仪表盘)尤为重要。传统的屏幕截图工具可能会截取不完整的渲染,而 Scrapingdog 的 API 可确保所有元素(包括懒加载的图像和 JavaScript 驱动的内容)完全可见。
自定义是截图 API 的另一个强项。用户可以指定视口大小、全页面捕获、设备模拟(台式机与移动设备),甚至基于地理位置的渲染等参数。这对于进行用户界面测试、监控本地化内容或分析网页在不同设备和地区的显示方式非常有价值。此外,API 还支持无头浏览器执行和自动渲染,从而减少了对 Selenium 或 Puppeteer 等附加基础架构的需求。
虽然 API 能有效处理大多数网页,但使用高级指纹识别和僵尸缓解技术的高度安全网站可能仍需要额外配置或其他刮擦方法。使用 API 的每个请求需要花费 25 Scrapingdog 信用点。
Webhook 集成
Webhook Integration(网络钩子集成)是 Scrapingdog 的一项重要功能,可通过实现异步搜刮和实时数据交付来优化大规模数据提取。对于需要频繁进行自动网络搜刮的企业来说,网络钩子消除了持续轮询的需要,确保搜刮到的数据在可用时直接推送到端点。
网络钩子系统采用基于回调的架构,允许用户发送刮擦请求,并在任务完成后立即接收提取的数据。用户无需等待同步 API 响应,只需提供一个网络钩子 URL,就能将刮擦数据传送到该 URL。请求处理完毕后,响应将存储在 “sid“中。您可以从仪表板访问网络钩子功能,登录仪表板后,点击 “网络钩子 “即可粘贴网络钩子 URL。

网络钩子框架充分考虑了安全性和可靠性。Scrapingdog 需要一个 API 密钥来验证传入的数据,以防止未经授权的访问,并确保只有受信任的来源才能与 webhook 端点交互。
不过,网络钩子集成也有一些技术前提条件。用户必须设置一个可公开访问的端点来接收数据,这可能需要额外的后端基础设施或云服务。这意味着非技术用户或不熟悉服务器端开发的用户可能会发现初始设置具有挑战性。此外,虽然网络钩子简化了数据交付,但对于需要更新数据的用例来说,它们可能不是最佳选择,因为它们只能存储响应的实例。处理时间还取决于 Scrapingdog 的刮擦队列和请求负载。
代理
Scrapingdog 提供代理服务,旨在提高网络搜刮能力。他们的代理服务器分为两大类:数据中心代理服务器和高级住宅代理服务器,每一类都能满足不同程度的搜刮复杂性和安全需求。
Scrapingdog 的数据中心代理是访问其网络搜刮 API 的另一种方法。这些代理服务器的工作原理是,在请求到达网络搜刮 API 之前,先通过专用代理服务器路由,从而确保对目标网站的可靠访问。不过,用户必须对代码进行相应配置,特别是禁用 SSL 验证,并在 URL 上使用 “http “而不是 “https”。这层额外的配置可能略有不便,但却是实现正常功能的必要步骤。
对于更具挑战性的搜索场景,Scrapingdog 提供高级住宅代理服务器。在 API 请求中添加premium=true参数即可激活这些代理服务器,从而解锁高质量住宅 IP 网络,帮助避免检测和拦截。默认情况下,这些代理使用美国的 IP,但需要地理定位选项的用户可以访问其他国家的 IP。值得注意的是,使用高级住宅代理服务器每次请求需支付 10 个信用点,启用 JavaScript 渲染功能后会增加到 25 个信用点。虽然这种定价模式能确保更高的成功率,但对于管理大规模刮擦操作的用户来说,这可能是一个影响因素。
定价和计划
Scrapingdog 提供多个定价层级,以满足不同需求:
| 计划 | 每月费用 | 包括 API 调用 | 并发请求 | 特点 |
| 轻型 | $40 | 200,000 | 最多 5 | – JavaScript 渲染 – 数据中心和住宅代理 – 地理定位 – 访问 LinkedIn 和 Google 搜索 API |
| 标准 | $90 | 1,000,000 | 高达 50 | – 精简版计划的所有功能 – 优先电子邮件支持 |
| 专业 | $200 | 3,000,000 | 高达 100 | – 标准计划的所有功能 |
| 企业 | 起价 350 美元 | 5,000,000+ | 超过 100 | – 专业计划的所有功能 – 可根据具体要求协商条款 |
如何使用 Scrapingdog
Scrapingdog 专为熟悉 API 交互的用户设计。
设置过程
- 要开始使用 Scrapingdog,用户必须先在平台上创建一个账户。
- 注册时会提供一个唯一的 API 密钥,作为 API 请求的主要验证方法。
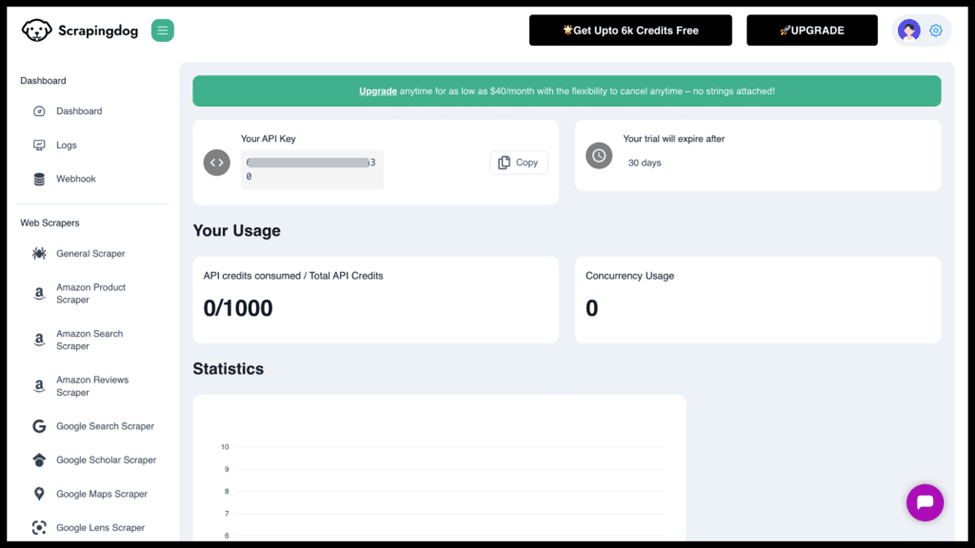
核心功能包括向 Scrapingdog 的 API 端点(https://api.Scrapingdog.com/scrape) 发送 GET 请求,其中包括两个基本参数:api_key和目标网页的url。
通过这一过程,用户可以检索所需网页的 HTML 内容。应用程序接口用途广泛,支持 Python、Node.js 和 PHP 等多种编程语言,便于集成到各种应用程序中。
如何管理订阅和使用
Scrapingdog 采用订阅模式,提供多个层级以满足不同的刮擦要求。每个订阅计划分配特定数量的信用点数,信用点数的消耗基于所发出的 API 请求类型。例如,使用旋转代理的标准网络刮擦请求通常每次请求消耗一个信用点数。
不过,JavaScript 渲染或高级住宅代理等更高级的功能,每次请求的信用额度成本会更高。用户可以通过 Scrapingdog 控制面板监控信用额度的使用情况并管理订阅计划,确保自己的信用额度不超过分配的限额,并根据需要调整计划,以满足自己的数据提取需求。
文件和支持
文档涵盖 Scrapingdog 提供的 API(如 Google、LinkedIn、Yelp、Indeed、Zillion 等)的详细信息;文档内容包括
1.API 参考– 所有 API 端点、参数和验证方法的说明,以确保顺利集成到不同的应用程序中。
2.错误处理– 有关 API 响应代码和错误信息的信息。
3.如何使用可用的产品 API– 包括所有参数、说明、API 示例和响应、
不过,文档编制工作还可以做得更好。有了结构化的
- 信息架构、
- 快速入门指南 – 使用 Python、JavaScript 和 PHP 等各种编程语言设置 API 请求的分步说明。
- 代码示例 – 现成可用的代码片段,演示常见的使用案例,如搜索电子商务产品详细信息、提取社交媒体数据和监控价格变化。
Scrapingdog 提供多种支持渠道,包括
- 电子邮件支持– 您可以通过电子邮件提交询问,通常在几小时内即可收到回复。
- 即时聊天 – 在网站上提供,让您获得客户支持代理的实时帮助。
- 社区论坛和常见问题– 包含常见问题和社区讨论的知识库,可帮助您独立排除故障。
- 企业支持计划– 为需要专门协助和优先响应的企业用户提供定制支持选项。
虽然支持系统效率很高,但响应时间可能因您订购的计划而异,但高级用户可获得更快的支持。
结论
Scrapingdog 是开发人员寻找简单、经济实惠的网络搜刮 API 的可靠选择。它能有效地处理代理、验证码和 JavaScript 渲染等问题,因此对许多刮擦任务都很有用。
但是,对于需要结构化数据提取、更广泛的地理定位或更强大的企业级解决方案的用户来说,Bright Data 的 Scraper API 是一个极佳的选择。它为 100 多个网站提供专用的 Scraper API,具有卓越的可靠性和广泛的全球代理覆盖范围,是大规模数据收集的顶级选择。
总之,Scrapingdog 是一款可靠、经济高效、易于使用的网络搜刮解决方案,非常适合开发人员使用。
常见问题
是的,Scrapingdog 提供免费试用版,允许用户通过有限的 API 调用来测试服务。请访问他们的网站注册并访问免费试用版。
Scrapingdog为Google服务、亚马逊等电子商务平台、LinkedIn和Twitter等社交媒体平台提供专用的API,并为就业市场和房地产提供专门的API。
你可以使用Scrapingdog的API进行集成,方法是发送GET请求到https://api.Scrapingdog.com/scrape,并附上你的API密钥和目标URL。他们支持 Python、Node.js 和 PHP 等多种编程语言。
Scrapingdog提供多种支持渠道,包括电子邮件支持、即时聊天、社区论坛和专门的企业支持计划,以提供量身定制的帮助。


Leave a Review
Required fields are marked *